مانیتورینگ شبکه سازمانی: راهنمای جامع پایش، مدیریت و پیشگیری از اختلالات شبکه
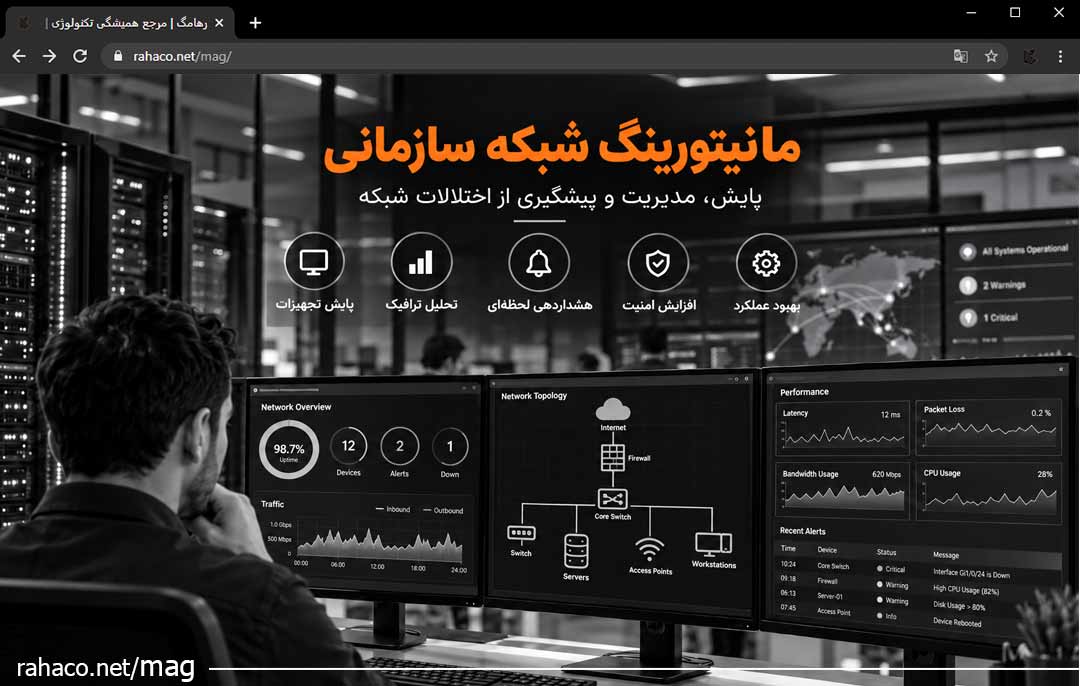
تصور کنید در ابتدای یک روز کاری، دهها کارمند همزمان اعلام میکنند که نرمافزارهای سازمان کند شدهاند، ارتباط با سرور قطع و وصل میشود و دسترسی به اینترنت نیز کیفیت همیشگی را ندارد. تیم IT از یک سو وضعیت سرورها را بررسی میکند و از سوی دیگر به سراغ سوئیچها، روترها و لینکهای ارتباطی میرود؛ اما هنوز مشخص نیست مشکل دقیقا از کجاست. در چنین شرایطی، تفاوت میان یک زیرساخت سنتی و یک شبکه حرفهای مشخص میشود. در شبکهای که مانیتورینگ شبکه سازمانی به درستی پیادهسازی شده باشد، مدیر شبکه برای پیدا کردن مشکل مجبور نیست تکتک تجهیزات را بررسی کند. سیستم مانیتورینگ میتواند وضعیت تجهیزات، ترافیک، پهنای باند، تأخیر، خطاها و بسیاری از شاخصهای دیگر را بهصورت مداوم بررسی کند و حتی پیش از جدی شدن اختلال هشدار دهد.
امروزه شبکه بخش حیاتی بسیاری از کسبوکارهاست. از سیستم حسابداری و اتوماسیون گرفته تا تلفن تحت شبکه، مجازیسازی، سرویسهای ابری و ارتباط میان شعب، همگی به عملکرد صحیح زیرساخت وابسته هستند. بنابراین مانیتورینگ شبکه دیگر یک قابلیت جانبی نیست؛ بلکه بخشی از مدیریت حرفهای فناوری اطلاعات محسوب میشود.
مانیتورینگ شبکه سازمانی چیست؟
مانیتورینگ شبکه سازمانی یا Enterprise Network Monitoring فرآیندی است که طی آن وضعیت تجهیزات، ارتباطات، سرویسها و ترافیک شبکه بهصورت پیوسته اندازهگیری و تحلیل میشود. هدف اصلی این فرآیند آن است که تیم فناوری اطلاعات بتواند به سه سؤال مهم پاسخ دهد: آیا تجهیزات و سرویسهای شبکه در دسترس هستند؟ آیا عملکرد آنها در محدوده طبیعی قرار دارد؟ و اگر مشکلی ایجاد شده است، علت اصلی آن چیست؟ برای رسیدن به این هدف، یک سیستم مانیتورینگ شبکه اطلاعات مختلفی را از تجهیزاتی مانند روتر، سوئیچ، فایروال، سرور، اکسس پوینت، ماشین مجازی و حتی سرویسهای ابری دریافت میکند. این اطلاعات سپس در قالب نمودار، داشبورد، گزارش و هشدار در اختیار مدیر شبکه قرار میگیرد.
چرا سازمانها به مانیتورینگ شبکه سازمانی نیاز دارند؟
در شبکههای کوچک شاید بتوان بعضی مشکلات را بهصورت دستی پیدا کرد؛ اما با افزایش تعداد کاربران، تجهیزات، سرورها و شعب، این روش عملا کارایی خود را از دست میدهد. فرض کنید یک شرکت دارای ۱۵۰ کاربر، چند سرور فیزیکی، دهها ماشین مجازی، چندین سوئیچ، فایروال، ارتباط اینترنتی و یک دفتر شعبه باشد. بررسی دستی چنین زیرساختی نهتنها زمانبر است، بلکه احتمال نادیده گرفتن اختلال نیز بسیار بالاست.
شناسایی اختلال قبل از کاربران
یکی از مهمترین مزایای پایش شبکه سازمانی این است که تیم IT میتواند در بسیاری از مواقع قبل از اینکه کاربران متوجه مشکل شوند، آن را شناسایی کند. برای مثال، اگر مصرف حافظه یک سرور طی چند ساعت بهطور غیرعادی افزایش پیدا کند، سیستم مانیتورینگ میتواند قبل از هنگ کردن سرور هشدار صادر کند.
کاهش زمان عیبیابی
بدون مانیتورینگ، متخصص شبکه باید برای پیدا کردن علت کندی یک سرویس بخشهای مختلف زیرساخت را بررسی کند. اما سیستم مانیتورینگ میتواند نشان دهد که برای مثال Packet Loss روی یک لینک افزایش یافته یا CPU یک فایروال به ۹۵ درصد رسیده است. این اطلاعات محدوده جستوجوی مشکل را بسیار کوچکتر میکند.
افزایش پایداری سرویسها
پایداری شبکه فقط به خرید تجهیزات قدرتمند وابسته نیست. تجهیزات مناسب زمانی بیشترین کارایی را دارند که وضعیت آنها به طور مستمر پایش شود. مانیتورینگ شبکه سازمانی امکان تشخیص روندهای غیرعادی و جلوگیری از بسیاری از Downtimeها را فراهم میکند.
چه بخشهایی از شبکه باید مانیتور شوند؟
یک نرم افزار مانیتورینگ شبکه حرفهای معمولا تنها یک شاخص را بررسی نمیکند. برای دستیابی به دید کامل، باید مجموعهای از معیارها بهصورت همزمان تحلیل شوند.
وضعیت تجهیزات شبکه
روترها، سوئیچها، فایروالها و اکسس پوینت ها از اولین تجهیزاتی هستند که باید مانیتور شوند. مواردی مانند: وضعیت روشن یا خاموش بودن دستگاه، CPU، RAM، دما، وضعیت Power Supply و Interfaceها اطلاعات ارزشمندی درباره سلامت تجهیزات ارائه میدهند.
سرورها و زیرساخت مجازی
در شبکههای سازمانی بسیاری از سرویسها روی سرورهای فیزیکی و ماشینهای مجازی اجرا میشوند. بنابراین مانیتورینگ شبکه سازمانی باید مواردی مانند پردازنده، حافظه، فضای ذخیرهسازی، وضعیت ماشینهای مجازی و سرویسهای مهم را نیز شامل شود.
پهنای باند
گاهی مشکل شبکه ناشی از خرابی تجهیزات نیست؛ بلکه یک کاربر، نرمافزار یا فرآیند حجم زیادی از پهنای باند را مصرف میکند. مانیتورینگ پهنای باند کمک میکند مشخص شود چه بخشی از شبکه بیشترین ترافیک را ایجاد کرده است. برای مثال، اگر در ساعات خاصی سرعت شبکه کاهش پیدا کند، بررسی ترافیک ممکن است نشان دهد یک فرآیند بکاپ در همان ساعت بخش زیادی از ظرفیت لینک را مصرف میکند.
مهمترین شاخصهای مانیتورینگ شبکه سازمانی
Latency چیست؟
Latency یا تأخیر نشان میدهد انتقال داده از یک نقطه شبکه به نقطه دیگر چه مدت زمان میبرد. افزایش Latency میتواند باعث کند شدن برنامههای تحت شبکه، Remote Desktop، تماسهای VoIP و سیستمهای مجازی شود.
Packet Loss چیست؟
در زمان انتقال اطلاعات، دادهها در قالب Packet جابهجا میشوند. اگر بخشی از این بسته ها در مسیر از بین بروند، اصطلاحا Packet Loss اتفاق افتاده است. مقدار بالای Packet Loss میتواند نشانه ازدحام شبکه، خرابی لینک، کابل نامناسب یا مشکل تجهیزات باشد.
Jitter چیست؟
Jitter به تغییرات زمانی در رسیدن بسته ها اشاره دارد. این معیار به خصوص در سرویسهایی مانند تماس صوتی و تصویری اهمیت دارد؛ زیرا افزایش Jitter ممکن است باعث قطع و وصل شدن صدا یا تصویر شود.
Uptime چیست؟
Uptime مدت زمانی را نشان میدهد که یک سرویس یا دستگاه بدون قطعی فعال بوده است. در سازمانهایی که SLA یا توافق سطح خدمات دارند، بررسی Uptime اهمیت ویژهای پیدا میکند.
Bandwidth Utilization
این شاخص نشان میدهد چه میزان از ظرفیت یک لینک مورد استفاده قرار گرفته است.برای مثال، اگر یک لینک یک گیگابیتی بهطور مداوم در محدوده بسیار بالای ظرفیت خود فعالیت کند، احتمال ایجاد Bottleneck یا گلوگاه افزایش پیدا میکند. شاخصهایی مانند: Latency، Jitter، Packet Loss و Bandwidth Utilization از معیارهای اصلی Network Performance Monitoring محسوب میشوند.
SNMP در مانیتورینگ شبکه سازمانی چیست؟
یکی از رایجترین فناوریها در مانیتورینگ تجهیزات شبکه پروتکل SNMP یا Simple Network Management Protocol است. SNMP به نرمافزار مانیتورینگ اجازه میدهد اطلاعاتی مانند میزان مصرف CPU، وضعیت Interfaceها، حجم ترافیک و بسیاری از پارامترهای دیگر را از تجهیزات دریافت کند. برای مثال، سیستم مانیتورینگ میتواند در بازههای زمانی مشخص وضعیت یک سوئیچ را از طریق SNMP بررسی کند و نتیجه را در قالب نمودار نمایش دهد. در محیطهای حرفهای بهتر است در صورت پشتیبانی تجهیزات از نسخههای امنتر مانند SNMPv3 استفاده شود؛ زیرا امکانات احراز هویت و رمزنگاری مناسبتری نسبت به نسخههای قدیمی ارائه میکند.
NetFlow چه کاربردی در مانیتورینگ دارد؟
SNMP معمولا به شما میگوید یک Interface چه مقدار ترافیک دارد؛ اما همیشه مشخص نمیکند این ترافیک توسط چه سیستم یا برنامهای ایجاد شده است. اینجاست که فناوریهایی مانند: NetFlow، sFlow و IPFIX اهمیت پیدا میکنند. NetFlow اطلاعات مربوط به جریانهای ترافیکی شبکه را جمعآوری میکند و میتواند مشخص کند ترافیک میان چه مبدا و مقصدی ردوبدل شده است.
فرض کنید مصرف اینترنت سازمان ناگهان افزایش پیدا کرده است. SNMP ممکن است نشان دهد لینک اینترنت تقریبا اشباع شده؛ اما تحلیل Flow میتواند به مدیر شبکه کمک کند متوجه شود کدام IP یا برنامه بیشترین مصرف را ایجاد کرده است. ترکیب SNMP با دادههای Flow دید دقیقتری از وضعیت شبکه ایجاد میکند؛ زیرا SNMP بیشتر وضعیت تجهیزات و Interfaceها را نشان میدهد و Flow برای تحلیل منابع و مقصدهای ترافیک مناسب است.
هشداردهی یا Alerting چگونه باید تنظیم شود؟
یکی از مهمترین امکانات هر ابزار مانیتورینگ شبکه سیستم هشداردهی آن است. اما فعال کردن تعداد زیادی هشدار الزاما به معنی مانیتورینگ بهتر نیست. اگر برای هر تغییر کوچک دهها هشدار ارسال شود، کارشناسان پس از مدتی به پیامها بیتوجه میشوند؛ پدیدهای که Alert Fatigue نام دارد. بنابراین هشدارها باید براساس اهمیت تعریف شوند.
نمونه هشدار بحرانی
قطع شدن فایروال اصلی یا سرور حیاتی میتواند هشدار با سطح Critical ایجاد کند.
نمونه هشدار Warning
رسیدن فضای دیسک یک سرور به ۸۰ درصد ممکن است در سطح Warning قرار گیرد تا تیم IT قبل از پر شدن کامل فضای ذخیرهسازی اقدام کند. تنظیم Baseline نیز اهمیت زیادی دارد. Baseline در واقع تصویری از وضعیت طبیعی شبکه است و به سیستم کمک میکند رفتار غیرعادی را بهتر تشخیص دهد. استفاده از Baseline، نقشه توپولوژی و هشدارهای معنادار از توصیههای مهم در مانیتورینگ شبکه سازمانی مدرن است.
Root Cause Analysis چیست؟
تصور کنید کاربران اعلام میکنند دسترسی به یک برنامه سازمانی کند شده است. ممکن است مشکل از سرور برنامه، پایگاه داده، سوئیچ، WAN، DNS یا حتی لینک اینترنت باشد. Root Cause Analysis یا تحلیل علت ریشهای تلاش میکند به جای مشاهده تنها نتیجه مشکل، عامل اصلی آن را شناسایی کند.
برای مثال: کاربر کندی نرمافزار را گزارش میکند. سیستم مانیتورینگ شبکه سازمانی افزایش Latency را تشخیص میدهد. همزمان Packet Loss روی لینک WAN مشاهده میشود. با بررسی دادههای Flow مشخص میشود یک انتقال حجیم اطلاعات لینک را اشباع کرده است. در این مثال، کندی نرمافزار تنها یک نشانه بوده و علت اصلی اشباع لینک است.
تفاوت Network Monitoring و Network Observability چیست؟
این دو مفهوم به یکدیگر نزدیک هستند، اما کاملا یکسان نیستند. مانیتورینگ شبکه معمولا روی مجموعهای از شاخصهای از پیش تعریفشده تمرکز میکند؛ برای مثال وضعیت CPU، RAM، Latency یا پهنای باند. اما Network Observability تلاش میکند دادههای مختلف مانند: Metrics، Logs، Flow و Telemetry را کنار یکدیگر قرار دهد و تصویری عمیقتر از رفتار زیرساخت ارائه کند.
به زبان ساده، مانیتورینگ معمولا به سؤال «چه اتفاقی افتاده است؟» پاسخ میدهد؛ در حالی که Observability تلاش میکند مشخص کند «چرا این اتفاق افتاده است؟». در شبکههای Hybrid و Multicloud اهمیت این رویکرد بیشتر شده است، زیرا زیرساخت ممکن است همزمان شامل دیتاسنتر داخلی، سرویس ابری و چندین شعبه باشد.
ابزارهای مانیتورینگ شبکه سازمانی
ابزارهای مختلفی برای مانیتورینگ لحظهای شبکه وجود دارند و نمیتوان یک نرمافزار را برای تمام سازمانها بهترین گزینه دانست.
Zabbix
Zabbix یکی از ابزارهای شناختهشده Open Source برای مانیتورینگ زیرساخت است. این پلتفرم امکان پایش سرورها، تجهیزات شبکه و سرویسهای مختلف را فراهم میکند و برای سازمانهایی که به دنبال انعطافپذیری و کنترل بالا هستند گزینه قابل بررسی محسوب میشود.
PRTG
PRTG نیز یکی از ابزارهای شناختهشده مانیتورینگ است که از سنسورهای متنوع برای بررسی Ping، SNMP، Flow و سرویسهای مختلف استفاده میکند. برای مثال، Sensor مربوط به Ping میتواند Response Time و Packet Loss را اندازهگیری کند و سنسورهای Flow امکان تحلیل ترافیک را فراهم میکنند.
SolarWinds
سولار ویندز مجموعهای از ابزارهای مدیریت و پایش زیرساخت شبکه ارائه میکند و امکان جمعآوری داده از منابعی مانند: SNMP، Flow و Log را دارد. انتخاب ابزار باید براساس مقیاس شبکه، تعداد تجهیزات، نوع زیرساخت، بودجه، مهارت تیم IT و نیازهای گزارشگیری انجام شود.
مراحل پیادهسازی مانیتورینگ شبکه سازمانی
پیادهسازی موفق مانیتورینگ شبکه بهتر است مرحله به مرحله انجام شود.
مرحله اول؛ شناسایی داراییها
ابتدا باید مشخص شود چه تجهیزاتی در شبکه وجود دارند. سوئیچها، روترها، سرورها، فایروالها، اکسس پوینت ها، هایپروایزرها و سرویسهای اصلی باید در Inventory ثبت شوند.
مرحله دوم؛ مشخص کردن سرویسهای حیاتی
همه تجهیزات اهمیت یکسان ندارند. برای مثال، قطع شدن یک پرینتر اداری قابل مقایسه با قطع شدن Core Switch یا سرور ERP نیست. بنابراین سرویسها باید اولویتبندی شوند.
مرحله سوم؛ انتخاب شاخصها
برای هر سیستم باید مشخص شود چه شاخصهایی نیاز به مانیتورینگ دارند. CPU، RAM، Storage، Interface Status، Packet Loss، Latency و Bandwidth از رایجترین موارد هستند.
مرحله چهارم؛ تعریف Threshold
Threshold حدی است که در صورت عبور یک شاخص از آن، هشدار ایجاد میشود. برای مثال میتوان مشخص کرد اگر مصرف CPU یک سرور برای مدت مشخصی بیشتر از ۹۰ درصد باقی ماند، سیستم هشدار ارسال کند.
مرحله پنجم؛ ایجاد Dashboard
داشبورد خوب باید مهمترین اطلاعات را بدون پیچیدگی اضافی نمایش دهد. مدیر IT باید بتواند با یک نگاه وضعیت سرویسهای حیاتی، لینکها و تجهیزات اصلی را بررسی کند.
مرحله ششم؛ بازبینی دورهای
مانیتورینگ یک پروژه یکباره نیست. با اضافه شدن سرور، تغییر معماری شبکه یا افزایش تعداد کاربران باید تنظیمات سیستم مانیتورینگ نیز بهروزرسانی شود.
اشتباهات رایج در مانیتورینگ شبکه سازمانی
یکی از اشتباهات متداول این است که سازمان صرفا یک نرم افزار مانیتورینگ شبکه نصب کند و تصور کند فرآیند مانیتورینگ تکمیل شده است. نصب ابزار فقط اولین قدم است. تعریف نکردن Thresholdهای مناسب، ارسال تعداد بیش از حد هشدار، مانیتور نکردن بکاپ، نادیده گرفتن تجهیزات جدید و نگهداری نکردن دادههای تاریخی میتواند ارزش سیستم را بهشدت کاهش دهد. اشتباه دیگر تمرکز صرف بر Up یا Down بودن تجهیزات است. ممکن است یک سرور روشن باشد، اما به دلیل فشار زیاد روی پردازنده عملا سرویس مناسبی ارائه نکند. بنابراین وضعیت پرفورمنس نیز باید بررسی شود.
نقش مانیتورینگ در ظرفیتسنجی شبکه
یکی از کاربردهای کمتر دیدهشده مانیتورینگ، Capacity Planning یا برنامهریزی ظرفیت است. دادههای تاریخی میتوانند نشان دهند مصرف پهنای باند، RAM، CPU یا Storage در طول چند ماه چگونه تغییر کرده است. اگر مصرف استوریج هر ماه تقریبا ۱۰ درصد افزایش پیدا کند، تیم IT میتواند قبل از رسیدن به نقطه بحرانی برای توسعه فضای ذخیرهسازی برنامهریزی کند. در نتیجه مانیتورینگ شبکه سازمانی فقط ابزاری برای واکنش به مشکلات نیست؛ بلکه اطلاعات مفیدی برای تصمیمگیریهای آینده نیز ارائه میدهد.
مانیتورینگ شبکه چه نقشی در امنیت دارد؟
مانیتورینگ عملکرد شبکه جایگزین ابزارهای امنیتی مانند: Firewall، SIEM یا NDR نیست، اما میتواند مکمل مهمی برای آنها باشد. برای مثال افزایش ناگهانی ترافیک یک دستگاه در ساعتی غیرمعمول ممکن است نیاز به بررسی بیشتر داشته باشد. تحلیل ترافیک شبکه میتواند رفتارهای غیرعادی را نسبت به الگوی طبیعی شبکه آشکار کند و در برخی سامانهها از روشهایی مانند تحلیل رفتاری و ماشین یادگیری نیز برای تشخیص Anomaly استفاده میشود. بنابراین در زیرساختهای بزرگ بهتر است دادههای مانیتورینگ با فرآیندهای امنیتی سازمان نیز ارتباط داشته باشند.
مانیتورینگ شبکه سازمانی برای چه کسبوکارهایی ضروریتر است؟
تقریبا هر سازمانی که فعالیت آن به IT وابسته است میتواند از مانیتورینگ سود ببرد، اما اهمیت آن در برخی محیطها بیشتر است. سازمانهای چندشعبهای، دیتاسنترها، مراکز درمانی، بانکها، کارخانهها، شرکتهای ارائهدهنده خدمات آنلاین و سازمانهایی که از زیرساخت مجازیسازی استفاده میکنند، معمولا وابستگی بیشتری به پایداری شبکه دارند. در چنین محیطهایی حتی چند دقیقه اختلال ممکن است فعالیت تعداد زیادی کاربر یا سرویس را تحت تأثیر قرار دهد.
آینده مانیتورینگ شبکه؛ از پایش تا تحلیل هوشمند
با پیچیدهتر شدن زیرساختهای IT، روشهای سنتی مانیتورینگ بهتنهایی کافی نیستند. شبکههای مدرن ممکن است شامل دیتاسنتر داخلی، Cloud، SaaS، SD-WAN، تجهیزات IoT و کاربران ریموت باشند. به همین دلیل ابزارهای جدید تلاش میکنند اطلاعات منابع مختلف را با یکدیگر Correlate کنند. در این رویکرد، هدف فقط مشاهده نمودار نیست؛ بلکه سیستم باید بتواند از میان حجم زیادی از Telemetry، اطلاعاتی را استخراج کند که مستقیما به تشخیص مشکل کمک میکنند. به همین دلیل مفاهیمی مانند: Network Observability، Anomaly Detection، Root Cause Analysis و AIOps در نسل جدید سیستمهای مانیتورینگ اهمیت بیشتری پیدا کردهاند.
جمعبندی
مانیتورینگ شبکه سازمانی یکی از پایههای مدیریت حرفهای زیرساخت فناوری اطلاعات است. سازمانی که دید دقیقی از عملکرد شبکه خود ندارد، معمولا زمانی از مشکل مطلع میشود که کاربران آن را گزارش کردهاند. در مقابل، یک سیستم مانیتورینگ اصولی میتواند: وضعیت سرورها، تجهیزات شبکه، پهنای باند، Latency، Packet Loss، Flowها و سرویسهای حیاتی را بهصورت مستمر بررسی کند.
شناسایی صحیح تجهیزات، تعیین KPI، طراحی Threshold مناسب، ایجاد هشدارهای هدفمند، تحلیل دادههای تاریخی و بازبینی مداوم سیستم بسیار اهمیت دارند. در نهایت، هرچه وابستگی کسبوکار به فناوری اطلاعات بیشتر باشد، داشتن دید لحظهای و دقیق نسبت به شبکه ارزش بیشتری پیدا میکند. در یک زیرساخت حرفهای، هدف نهایی این نیست که بعد از وقوع مشکل سریعتر متوجه آن شویم؛ هدف این است که بسیاری از مشکلات را پیش از تبدیل شدن به اختلال جدی شناسایی و مدیریت کنیم.