مدیریت رخداد IT چیست؟ راهنمای جامع Incident Management در سازمانها
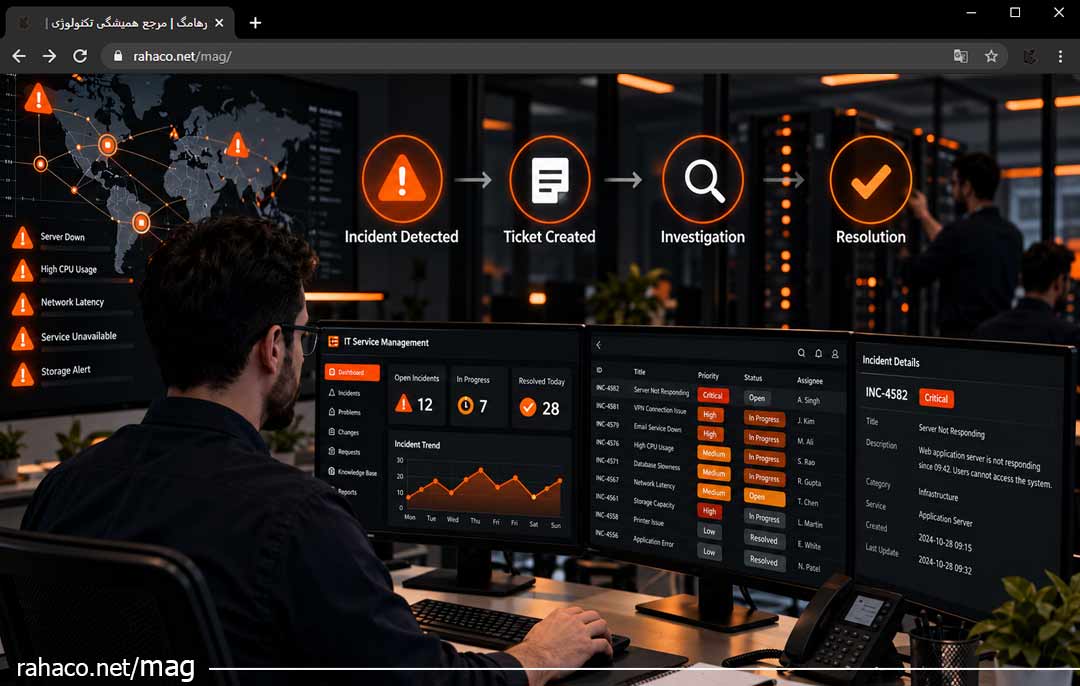
تصور کنید صبح یک روز کاری، درست زمانی که کارکنان آماده شروع فعالیت هستند، ارتباط با سرور اصلی شرکت قطع میشود. نرمافزار حسابداری در دسترس نیست، کاربران نمیتوانند وارد سیستم شوند و تماسهای واحد پشتیبانی یکی پس از دیگری افزایش پیدا میکند. در چنین شرایطی، سؤال اصلی این نیست که چه کسی مقصر است؛ بلکه باید مشخص شود چگونه میتوان خدمات سازمان را در کوتاهترین زمان ممکن بازیابی کرد؟
اینجاست که اهمیت مدیریت رخداد IT مشخص میشود. بسیاری از سازمانها تجهیزات پیشرفته و زیرساختهای قدرتمندی دارند، اما هنگام بروز اختلال، برنامه مشخصی برای واکنش سریع ندارند. نتیجه چنین وضعیتی، افزایش زمان قطعی، کاهش بهرهوری کارکنان و تحمیل هزینههای پیشبینینشده است. مدیریت رخداد در فناوری اطلاعات، رویکردی ساختاریافته برای شناسایی، ثبت، اولویتبندی و برطرف کردن اختلالات است. در این مقاله بررسی میکنیم که Incident Management چیست، چه مراحلی دارد و چگونه میتواند کیفیت خدمات فناوری اطلاعات را در سازمان بهبود دهد.
مدیریت رخداد IT چیست؟
مدیریت رخداد IT یا Incident Management مجموعهای از فعالیتهای هماهنگ برای شناسایی، بررسی و برطرف کردن اختلالاتی است که عملکرد طبیعی خدمات فناوری اطلاعات را مختل میکنند یا کیفیت آنها را کاهش میدهند. هدف اصلی این فرآیند، بازگرداندن سرویس به وضعیت عملیاتی قابلقبول در سریعترین زمان ممکن و کاهش تأثیر اختلال بر فعالیتهای تجاری است. برای مثال، قطع ارتباط اینترنت، از دسترس خارج شدن سرور، اختلال در ماشینهای مجازی و کاهش شدید سرعت نرمافزارهای سازمانی میتوانند نمونههایی از رخداد IT باشند. بر اساس رویکرد ITIL، مدیریت رخداد یکی از فعالیتهای مهم مدیریت خدمات فناوری اطلاعات یا ITSM محسوب میشود. این رویکرد تأکید دارد که بازیابی خدمات باید بهشکلی قابلاندازهگیری و مطابق اولویتهای کسبوکار انجام شود.
چرا مدیریت رخداد IT برای سازمانها اهمیت دارد؟
حتی یک اختلال کوتاهمدت ممکن است فرآیندهای عملیاتی سازمان را تحت تأثیر قرار دهد. هرچه وابستگی شرکت به خدمات دیجیتال بیشتر باشد، اهمیت مدیریت صحیح رخدادها نیز افزایش پیدا میکند.
کاهش زمان قطعی شبکه و سرورها
یکی از مهمترین مزایای مدیریت رخداد IT، کاهش مدت اختلال در سرویسهاست. هنگامی که مراحل شناسایی و رسیدگی مشخص باشند، کارشناسان بدون اتلاف وقت میتوانند اقدامات ضروری را آغاز کنند. جلوگیری از افزایش هزینههای عملیاتی اختلال در زیرساخت فناوری اطلاعات ممکن است باعث توقف تولید، تأخیر در ارائه خدمات یا کاهش فروش شود. مدیریت اصولی رخدادها با کوتاه کردن زمان بازیابی، به محدود شدن این خسارتها کمک میکند.
افزایش رضایت کاربران
وقتی کارکنان از وضعیت مشکل و زمان تقریبی بررسی آن اطلاع داشته باشند، اعتماد بیشتری به تیم پشتیبانی پیدا میکنند. اطلاعرسانی منظم همچنین از ثبت درخواستهای تکراری جلوگیری میکند.
بهبود امنیت و پایداری زیرساخت
ثبت اطلاعات رخدادها امکان شناسایی نقاط ضعف تکرارشونده را فراهم میکند. برای مثال، تکرار اختلال در یک سرویس میتواند نشانه نیاز به بررسی ظرفیت منابع یا اصلاح تنظیمات آن باشد.
تفاوت Incident و Problem در فناوری اطلاعات چیست؟
یکی از اشتباهات متداول، یکسان دانستن رخداد و مشکل است؛ درحالیکه این دو مفهوم اهداف متفاوتی دارند.
ویژگی Incident یا رخداد Problem یا مشکل
تعریف اختلال یا کاهش کیفیت یک سرویس علت یا علتهای احتمالی یک یا چند رخداد
هدف بازیابی سریع سرویس شناسایی و کنترل علت اصلی
اولویت کاهش اثر فوری اختلال پیشگیری از تکرار رخداد
نمونه قطع اتصال کاربران به سرور خرابی مکرر یک قطعه شبکه
فرض کنید ارتباط کاربران با سرور فایل قطع شده است. تیم پشتیبانی با انتقال ترافیک به مسیر جایگزین، سرویس را بازیابی میکند. این اقدام در حوزه مدیریت رخداد قرار دارد. اما بررسی اینکه چرا مسیر اصلی ارتباطی مرتب قطع میشود، بخشی از Problem Management یا مدیریت مشکل است.در نتیجه، مدیریت رخداد بر بازیابی سرویس تمرکز دارد، نه لزوماً حذف فوری علت ریشهای اختلال
مراحل مدیریت رخداد IT بر اساس چارچوب ITIL
اجرای موفق فرآیند مدیریت رخداد IT نیازمند مراحل مشخص و مسئولیتهای تعریفشده است. سازمانها میتوانند این مراحل را متناسب با اندازه و پیچیدگی زیرساخت خود تنظیم کنند.
۱. شناسایی رخداد (Incident Identification)
نخستین مرحله، تشخیص اختلال در سرویسهای فناوری اطلاعات است. رخداد ممکن است از طریق گزارش کاربران، هشدار نرمافزارهای مانیتورینگ یا بررسی کارشناسان شناسایی شود. برای نمونه، سیستم مانیتورینگ میتواند افزایش مصرف پردازنده یا قطع دسترسی به سرور را گزارش دهد. تشخیص زودهنگام باعث میشود تیم فنی پیش از گسترش اختلال وارد عمل شود.
۲. ثبت رخداد (Incident Logging)
پس از شناسایی، اطلاعات باید در سیستم مدیریت تیکت IT ثبت شوند. این اطلاعات شامل زمان وقوع، سرویس تحت تأثیر، شرح اختلال، کاربران آسیبدیده و اقدامات انجامشده است. ثبت دقیق اطلاعات به کارشناسان کمک میکند سابقه رخداد را بررسی کنند و در صورت تغییر مسئول رسیدگی، اطلاعات مهم از بین نرود.
۳. دستهبندی و اولویتبندی رخدادها
همه اختلالات اهمیت یکسانی ندارند. خرابی یک چاپگر شخصی با از دسترس خارج شدن سامانه مالی سازمان قابلمقایسه نیست. در این مرحله، رخدادها بر اساس نوع مشکل، میزان تأثیر بر فعالیتهای سازمان و فوریت رسیدگی دستهبندی میشوند.
۴. بررسی اولیه و تشخیص مشکل
کارشناس پشتیبانی با بررسی گزارشها، وضعیت تجهیزات، سرویسها و تغییرات اخیر، علت احتمالی اختلال را شناسایی میکند. برای مثال، هنگام قطع ارتباط یک ماشین مجازی، باید وضعیت شبکه، میزبان مجازیسازی و فضای ذخیرهسازی بررسی شود.
۵. ارجاع به کارشناسان تخصصی (Escalation)
اگر رخداد در سطح اولیه پشتیبانی برطرف نشود، به تیم تخصصی ارجاع داده میشود. این ارجاع میتواند به کارشناس شبکه، مدیر سیستم، متخصص مجازیسازی یا تیم امنیت انجام شود. هدف آن است که مشکل بدون تأخیر غیرضروری به فرد دارای تخصص و اختیار مناسب منتقل شود.
۶. بازیابی سرویس و رفع اختلال
در این مرحله اقدامات لازم برای بازگرداندن عملکرد سرویس انجام میشود. راهکار ممکن است شامل اصلاح تنظیمات، فعالسازی مسیر جایگزین، بازیابی ماشین مجازی یا تعویض تجهیزات معیوب باشد. هر اقدام باید با ارزیابی ریسک انجام شود تا فرآیند بازیابی باعث ایجاد اختلال جدید نشود.
۷. تأیید بازیابی و بستن رخداد
پس از رفع اختلال، عملکرد سرویس بررسی و در صورت امکان با کاربر یا مالک سرویس تأیید میشود. سپس اقدامات، زمان بازیابی و نتیجه نهایی در پرونده رخداد ثبت خواهند شد.رخدادهای مهم نیز باید در جلسه بررسی پس از حادثه تحلیل شوند تا تجربههای بهدستآمده در بهبود زیرساخت استفاده شوند.
اولویتبندی رخدادهای IT چگونه انجام میشود؟
در مدیریت حرفهای، اولویت رخداد بر اساس دو معیار اصلی تعیین میشود: میزان تأثیر (Impact) و فوریت (Urgency). میزان تأثیر نشان میدهد اختلال چه تعداد کاربر یا کدام فرآیندهای حیاتی را درگیر کرده است. فوریت نیز مشخص میکند رسیدگی به رخداد تا چه اندازه باید سریع انجام شود. جدول زیر یک نمونه پیشنهادی برای اولویتبندی است:
اولویت وضعیت رخداد نمونه
- P1 بحرانی توقف خدمات حیاتی سازمان قطعی سرور اصلی
- P2 بالا اختلال جدی در یک بخش قطع ارتباط واحد مالی
- P3 متوسط اختلال محدود با راهکار جایگزین کندی یک نرمافزار
- P4 پایین تأثیر کم بر فعالیتها مشکل چاپگر یک کاربر
این دستهبندی باید بر اساس نیازهای هر سازمان تنظیم شود. برای مثال، اختلال در سامانه ثبت سفارش یک فروشگاه اینترنتی ممکن است حتی با تعداد کاربران محدود، اولویت بحرانی داشته باشد.
SLA چیست؟
SLA یا توافقنامه سطح خدمات، سندی است که تعهدات ارائهدهنده خدمات را مشخص میکند. این تعهدات میتوانند شامل زمان پاسخ اولیه، زمان هدف برای بازیابی سرویس و نحوه ارجاع رخدادهای بحرانی باشند. برای مثال، در یک قرارداد فرضی، زمان پاسخ اولیه به رخداد P1 میتواند ۱۵ دقیقه تعیین شود. این عدد یک استاندارد عمومی نیست و باید مطابق قرارداد و ظرفیت تیم پشتیبانی مشخص شود.
نقش SLA و شاخص MTTR در مدیریت رخداد IT
برای ارزیابی عملکرد تیم پشتیبانی، صرفاً تعداد رخدادهای بستهشده کافی نیست. سازمان باید زمان پاسخگویی و کیفیت بازیابی خدمات را نیز اندازهگیری کند.
MTTR چیست و چگونه محاسبه میشود؟
MTTR معمولا برای اندازهگیری میانگین زمان بازیابی یا رفع رخداد استفاده میشود؛ البته تعریف دقیق آن باید در گزارش سازمان مشخص باشد.
فرمول میانگین زمان بازیابی: \[ MTTR=\frac{\text{مجموع زمان بازیابی رخدادها}}{\text{تعداد رخدادها}} \]
اگر سه رخداد بهترتیب در ۳۰، ۶۰ و ۹۰ دقیقه بازیابی شوند، MTTR برابر با ۶۰ دقیقه خواهد بود. کاهش این شاخص، در کنار بررسی کیفیت راهکارها و میزان تکرار خرابیها، میتواند نشانه بهبود عملکرد پشتیبانی باشد.
بهترین ابزارهای مدیریت رخداد IT
اجرای اصولی مدیریت حوادث فناوری اطلاعات بدون ابزارهای مناسب دشوار است. انتخاب نرمافزار باید بر اساس تعداد کاربران، پیچیدگی زیرساخت و بودجه سازمان انجام شود.
ابزارهای مدیریت تیکت و خدمات IT
- Jira Service Management: برای ثبت، اولویتبندی و پیگیری رخدادها کاربرد دارد. این ابزار امکان هماهنگی تیمهای پشتیبانی و مدیریت گردش کار را فراهم میکند.
- ServiceNow: برای مدیریت خدمات فناوری اطلاعات در محیطهای سازمانی استفاده میشود و قابلیتهایی مانند خودکارسازی ارجاع رخدادها و مدیریت SLA دارد.
- ManageEngine ServiceDesk Plus: نیز امکاناتی برای ثبت درخواستها، تخصیص کارشناسان و مدیریت چرخه رسیدگی ارائه میدهد.
نقش مانیتورینگ و هوش مصنوعی
ابزارهای مانیتورینگ میتوانند وضعیت سرورها، شبکه و سرویسهای حیاتی را بهصورت مستمر بررسی کنند. همچنین فناوریهای مبتنی بر هوش مصنوعی با تحلیل هشدارها، شناسایی الگوهای تکراری و پیشنهاد راهکار، میتوانند فرآیند تشخیص و ارجاع رخدادها را سریعتر کنند. بااینحال، تصمیمهای حساس همچنان به نظارت کارشناسان نیاز دارند.
نمونه عملی مدیریت رخداد در یک سازمان
فرض کنید یک شرکت دارای زیرساخت مجازیسازی VMware است و چندین ماشین مجازی روی یک میزبان اجرا میشوند. ناگهان کاربران گزارش میکنند نرمافزار مالی از دسترس خارج شده است.
- بررسی اولیه: تیم پشتیبانی ابتدا وضعیت ارتباط شبکه، ماشین مجازی و منابع میزبان را بررسی میکند. مشخص میشود فضای ذخیرهسازی میزبان به ظرفیت بحرانی رسیده و عملکرد یکی از سرویسها مختل شده است.
- اقدامات بازیابی: کارشناسان پس از بررسی وابستگی سرویسها و رعایت الزامات ایمنی، فضای قابلبازیابی را شناسایی میکنند. سپس اقدامات اصلاحی کنترلشده انجام میدهند تا سرویس مالی دوباره در دسترس قرار گیرد.
- پیشگیری از تکرار اختلال: پس از بازیابی، آستانههای هشدار ظرفیت ذخیرهسازی اصلاح میشود. همچنین برنامهای برای بررسی رشد دادهها و افزایش ظرفیت تدوین خواهد شد. این مثال فرضی نشان میدهد که مدیریت رخداد IT فقط رفع قطعی نیست؛ بلکه زمینهای برای بهبود مستمر زیرساخت ایجاد میکند.
اشتباهات رایج در مدیریت رخداد IT
بعضی سازمانها با وجود برخورداری از کارشناسان متخصص، به دلیل ضعف در فرآیندهای اجرایی با اختلالات تکراری مواجه میشوند.یکی از اشتباهات، ثبت نکردن رخدادهای کوچک است. این موضوع باعث میشود الگوهای خرابی شناسایی نشوند.اشتباه دیگر، نداشتن اولویتبندی مشخص است. در چنین وضعیتی ممکن است کارشناسان برای حل مشکلات کماهمیت وقت صرف کنند، درحالیکه یک سرویس حیاتی از دسترس خارج شده است.نبود مستندات فنی، اطلاعرسانی نامناسب به کاربران و انجام تغییرات بدون ارزیابی ریسک نیز میتواند زمان بازیابی را افزایش دهد.راهکار مؤثر، تدوین فرآیندهای مشخص، آموزش کارشناسان و بررسی دورهای گزارش رخدادهاست.
نقش پشتیبانی IT سازمانی در مدیریت رخدادها
اجرای موفق مدیریت رخداد IT نیازمند ترکیبی از دانش فنی، ابزارهای مناسب و فرآیندهای استاندارد است. یک تیم پشتیبانی متخصص باید بتواند وضعیت زیرساخت را پایش کند، رخدادها را بر اساس اهمیت دستهبندی کند و هنگام بروز اختلال، هماهنگی لازم میان کارشناسان شبکه، سرور و مجازیسازی را برقرار سازد. استفاده از خدمات پشتیبانی IT رهاکو میتواند برای سازمانهایی که به دنبال ایجاد فرآیندهای منظم نگهداری و رسیدگی به اختلالات هستند، نقطه شروع مناسبی برای بررسی نیازهای فنی باشد.
پرسشهای متداول درباره مدیریت رخداد IT
- آیا مدیریت رخداد IT فقط برای شرکتهای بزرگ مناسب است؟ خیر. حتی کسبوکارهای کوچک نیز میتوانند با ثبت تیکتها، اولویتبندی درخواستها و تعیین مسئول رسیدگی، فرآیند مدیریت رخداد ساده و مؤثری ایجاد کنند.
- تفاوت Incident Management و ITSM چیست؟ ITSM مجموعهای از روشها و فعالیتهای مدیریت خدمات فناوری اطلاعات است. Incident Management یکی از بخشهای آن محسوب میشود که بر بازیابی سریع خدمات مختلشده تمرکز دارد.
- آیا مدیریت رخداد میتواند از تمام قطعیهای شبکه جلوگیری کند؟ خیر. هدف اصلی آن کاهش اثر و مدت اختلالات است. برای پیشگیری از خرابیها باید مدیریت مشکل، نگهداری پیشگیرانه، مانیتورینگ و مدیریت تغییرات نیز در کنار آن اجرا شوند.
نتیجهگیری
مدیریت رخداد IT یکی از پایههای اصلی پایداری خدمات فناوری اطلاعات در سازمانهاست. بدون فرآیند مشخص برای شناسایی و رفع اختلال، حتی زیرساختهای قدرتمند نیز ممکن است در زمان بروز بحران با مشکلات جدی مواجه شوند.ثبت دقیق رخدادها، اولویتبندی بر اساس تأثیر تجاری، استفاده از ابزارهای مانیتورینگ و ارزیابی شاخصهایی مانند MTTR به سازمانها کمک میکند خدمات خود را سریعتر بازیابی کنند.در نهایت، موفقیت مدیریت رخداد زمانی مشخص میشود که اختلالات با کمترین اثر بر فعالیتهای سازمان مدیریت شوند و تجربیات گذشته به بهبود کیفیت خدمات آینده کمک کنند.